

메타 ‘뮤즈 원더’ 출시…대화 기억하고 오류도 스스로 넘는 AI 에이전트
메타가 오픈AI·앤트로픽 등 선두 기업과 겨룰 수 있는 최상위 인공지능(AI) 모델 ‘뮤즈 원더(Muse Wonder)’와 ‘뮤즈 원더 풀(Muse Wonder Full)’을 12일(현지시간) 출시했다.
두 모델은 메타 초지능연구소(MSL)가 미국 오하이오주 중부에 있는 기가와트급 데이터센터 ‘프로메테우스’에서 개발했다. 메타는 대규모 사전학습에 강화학습을 결합해 만든 이 모델들이 소프트웨어 코딩은 물론 법률·금융·보건 등 전문 분야의 실무를 수행하는 에이전트 기능에서 업계 선두 모델과 어깨를 나란히 한다고 설명했다. 앞서 내놓은 경량 모델 ‘뮤즈 스파크(Muse Spark)’보다 규모와 성능을 크게 끌어올린 상위 제품군이다.
마크 저커버그 메타 최고경영자(CEO)는 “뮤즈 스파크가 우리의 첫 모델 제품군이었다면 훨씬 더 규모가 크고 보다 진보된 뮤즈 원더는 우리를 최첨단으로 이끌었다”고 밝혔다. 알렉산더 왕 최고AI책임자(CAIO)도 블룸버그 통신에 “이들 모델은 진정한 최첨단 모델”이라며 “현재 시중에서 가장 우수한 모델과도 경쟁력이 있다고 본다”고 말했다. 메타는 지난해 스케일AI에 약 18조8,000억원(140억달러)을 투자해 왕 CAIO를 영입하고 AI 조직을 재편했다. 이번 발표는 그 이후 처음 내놓는 프런티어 모델이다.
외부 평가에서도 성과가 확인됐다. AI 모델 평가업체 아티피셜어낼리시스는 지능지표(AAII)에서 뮤즈 원더 풀에 56점을 매겼다. 클로드 소네트 5.5와 같은 점수로, 선두인 클로드 오퍼스 5.5(58점)에 이은 공동 2위다. 뮤즈 원더는 52점으로 클로드 페이블 5.1, 오픈AI GPT-6 아스트라, 구글 제미나이4 아르곤(각 53점)에 이어 공동 7위에 올랐다. 전작 뮤즈 스파크 1.3(48점)보다 크게 높아진 수치다. 뮤즈 원더 풀은 10개 세부 평가 가운데 6개에서 상위 3위 안에 들었고, 코딩 에이전트 지표에서는 68점으로 클로드 소네트 5.5와 같았으며 오퍼스 5.5(66점)를 앞섰다. 다만 지식 정확도 평가에서는 30점으로 오퍼스 5.5(46점)에 못 미쳤다.
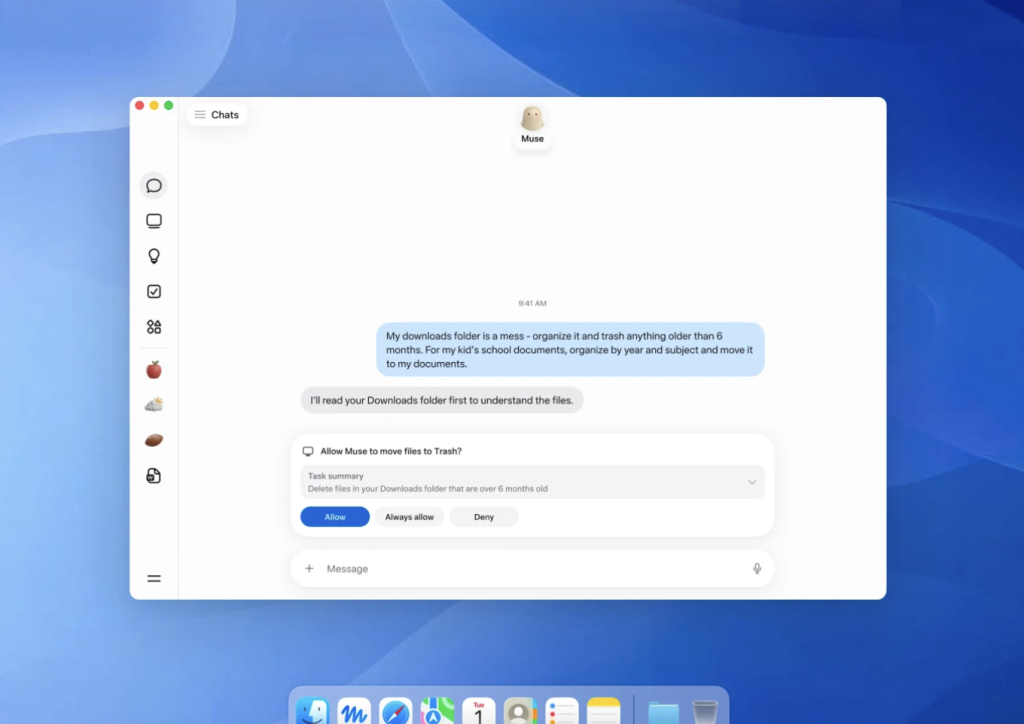
뮤즈 원더는 에이전트 구동에 초점을 맞췄다. 이용자와 나눈 대화 이력과 선호, 습관 등을 기억해 현재 작업에 활용하는 ‘액티브 메모리(Active Memory)’ 기능이 핵심이다. 복잡하거나 모호한 과제에서 오류가 생겨도 다른 접근법을 시도하며 목표를 완수하고, 필요하면 이용자에게 확인을 구하는 ‘액티브 포커스(Active Focus)’ 기능도 적용했다. 메타는 뮤즈 원더를 AI 에이전트 앱 ‘뮤즈’에 유료 구독자부터 순차 적용할 계획이다.
뮤즈 원더는 이날부터 메타 모델 API와 코딩 도구 ‘뮤즈 코드’를 통해 이용할 수 있다. API 가격은 100만 토큰당 입력 약 5,380원(4달러), 출력 약 2만6,900원(20달러)이다. 한 번에 처리할 수 있는 문맥 길이는 약 100만 토큰이며, 텍스트·이미지·영상 등을 입력받는다. 뮤즈 원더 풀은 API로 제공되지 않는다. 뮤즈 코드 유료 요금제인 ‘파워'(월 약 6만7,000원·50달러)와 ‘맥시멈'(월 약 26만9,000원·200달러) 가입자만 쓸 수 있다.
안전성도 강화했다. 메타는 두 모델이 허락 없이 개인정보를 공유하지 않고 유해 행위 지원 요청을 거부하도록 학습시켰으며, 사이버 공격 방어 능력도 높였다고 밝혔다. 세부 안전성 평가 보고서는 추후 공개할 예정이다.